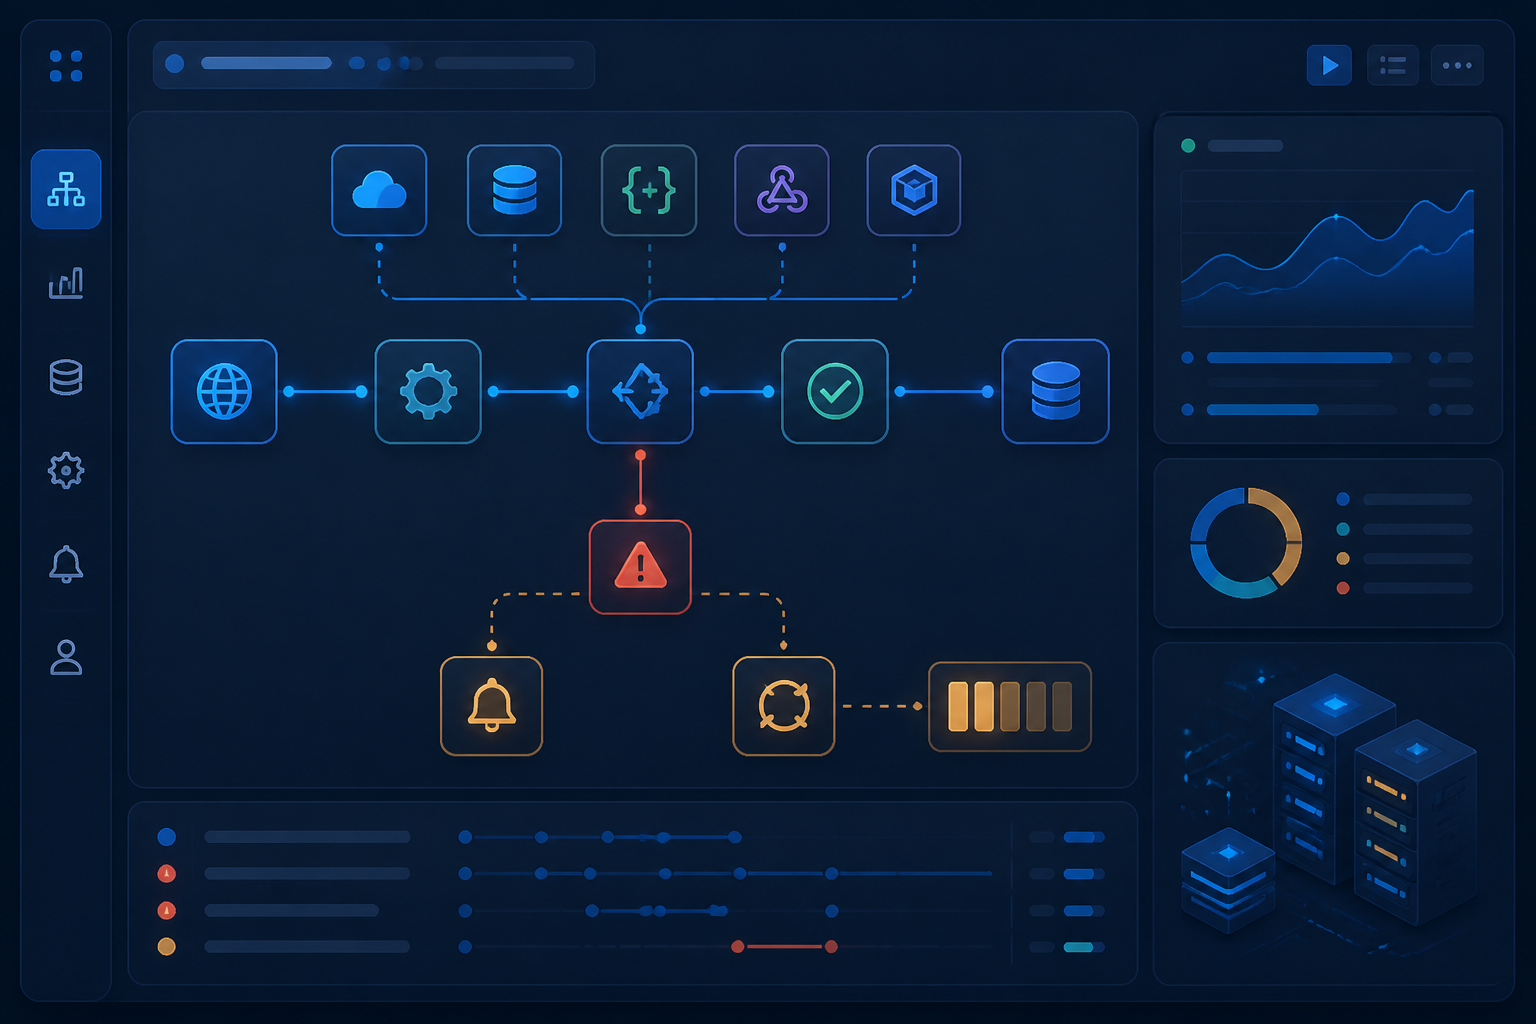
Workflow automation sering terlihat baik-baik saja sampai satu layanan eksternal mengalami gangguan. API pembayaran timeout, token kedaluwarsa, format data berubah, atau satu baris input ternyata kosong. Tanpa penanganan error yang jelas, masalahnya bisa berhenti sebagai notifikasi samar—atau lebih buruk lagi, tidak diketahui sampai seseorang menyadari ada pekerjaan yang tidak diproses.
Di n8n, error handling bukan hanya soal membuat workflow tetap berjalan. Tujuan utamanya adalah memastikan kegagalan bisa terdeteksi, dijelaskan, dan ditindaklanjuti. Dokumentasi n8n sendiri menyarankan agar kemungkinan error dipertimbangkan sejak tahap merancang alur kerja, bukan setelah workflow mulai bermasalah. Dokumentasi n8n tentang penanganan error juga menyediakan pola khusus untuk mengirim peringatan ketika eksekusi gagal.
Kenapa workflow yang gagal perlu diperlakukan berbeda?
Tidak semua error memiliki arti yang sama. Misalnya, API yang tidak merespons selama beberapa detik mungkin layak dicoba ulang. Sebaliknya, data pelanggan tanpa alamat email bukan masalah sementara. Mengulangnya berkali-kali hanya akan menghasilkan kegagalan yang sama.
Karena itu, workflow sebaiknya membedakan setidaknya tiga jenis kondisi:
- Error sementara: timeout, rate limit, atau layanan eksternal sedang tidak tersedia.
- Error data: field wajib kosong, format tanggal salah, atau nilai tidak sesuai aturan.
- Error desain atau konfigurasi: kredensial tidak valid, endpoint salah, atau node berubah setelah workflow diperbarui.
Pembedaan ini membantu menentukan respons. Error sementara mungkin perlu retry. Error data perlu masuk ke antrean pemeriksaan. Error konfigurasi harus segera diketahui oleh orang yang mengelola workflow.
Gunakan Error Trigger sebagai jalur darurat
n8n menyediakan Error Trigger untuk membuat error workflow. Workflow khusus ini dapat menerima detail dari workflow lain yang gagal, kemudian mengirim peringatan ke email, Slack, Telegram, atau sistem pencatatan insiden.
Pola sederhananya seperti ini:
- Buat workflow baru dengan
Error Triggersebagai node pertama. - Tambahkan node untuk mengambil informasi penting dari error tersebut.
- Kirim notifikasi ke kanal yang benar-benar dipantau.
- Pada workflow utama, buka pengaturan workflow dan pilih error workflow yang sudah dibuat.
Error workflow dapat digunakan oleh beberapa workflow sekaligus. Data yang diterima biasanya mencakup nama workflow, ID eksekusi, pesan error, node terakhir yang dijalankan, dan tautan ke detail eksekusi jika data eksekusinya tersimpan. Detail ini jauh lebih berguna daripada pesan seperti “workflow failed”.
Perlu diperhatikan, Error Trigger berjalan ketika workflow otomatis mengalami kegagalan. Pengujian dengan menjalankan workflow secara manual tidak selalu memicu perilaku error workflow yang sama. Karena itu, lakukan pengujian melalui mode dan pemicu yang mendekati kondisi produksi.
Jangan kirim notifikasi yang terlalu ramai
Notifikasi error yang masuk setiap beberapa menit akan cepat berubah menjadi kebisingan. Akhirnya, tim justru mengabaikan semua pesan, termasuk yang penting.
Notifikasi sebaiknya memuat informasi minimum berikut:
- Nama workflow.
- Waktu kegagalan.
- Node yang bermasalah.
- Pesan error singkat.
- Jenis data atau proses yang terdampak.
- Tautan ke execution detail jika tersedia.
- Saran tindakan: menunggu, retry, memperbaiki data, atau memeriksa kredensial.
Hindari memasukkan seluruh payload ke dalam pesan, terutama jika berisi nomor telepon, alamat, token, atau data pelanggan. Log yang terlalu lengkap bisa menjadi risiko privasi. Kirim ringkasan ke kanal notifikasi, lalu arahkan pengelola ke detail eksekusi yang memiliki akses terbatas.
Fail fast untuk data yang memang tidak layak diproses
Kesalahan tidak selalu muncul dari node yang rusak. Kadang workflow menerima data yang tidak memenuhi syarat, tetapi tetap dibiarkan berjalan. Akibatnya, error baru muncul jauh di belakang—misalnya ketika node pengiriman email atau penyimpanan database sudah dijalankan.
Untuk kondisi seperti ini, tambahkan pemeriksaan lebih awal menggunakan node If, Switch, atau validasi sederhana di Code. Jika syarat penting tidak terpenuhi, hentikan eksekusi dengan pesan yang jelas.
n8n menyediakan node Stop And Error untuk membuat eksekusi gagal secara sengaja pada kondisi tertentu. Node ini juga dapat mengirim pesan atau objek error khusus ke Error Trigger. Dokumentasi Stop And Error menjelaskan dua pendekatan: melempar pesan error atau objek error yang berisi informasi terstruktur.
Contohnya, daripada membiarkan data tanpa customer_id berjalan ke beberapa node berikutnya, workflow dapat menghentikannya dengan pesan seperti:
Data ditolak: customer_id kosong pada input order.Pesan semacam ini membantu orang memperbaiki sumber masalah tanpa harus menebak-nebak dari stack trace.
Bedakan retry dari pengulangan tanpa batas
Retry berguna jika kegagalan bersifat sementara. Namun retry tanpa batas dapat membuat sistem semakin lambat, menggandakan transaksi, atau membebani API yang sedang bermasalah.
Sebelum mengaktifkan retry, jawab tiga pertanyaan:
- Apakah operasi tersebut aman dijalankan ulang?
- Berapa kali percobaan yang masuk akal?
- Apa yang dilakukan jika semua percobaan gagal?
Untuk operasi seperti mengirim pesan atau membuat pesanan, pertimbangkan risiko duplikasi. Sebisa mungkin, gunakan ID unik atau mekanisme idempotensi dari layanan tujuan. Artinya, permintaan yang sama dapat diulang tanpa membuat efek samping ganda.
Untuk error sementara, pola yang lebih aman adalah mencoba ulang beberapa kali, memberi jeda, lalu memindahkan kasus yang tetap gagal ke jalur manual atau antrean pemeriksaan. Untuk error data, jangan retry otomatis. Perbaiki datanya terlebih dahulu.
Gunakan halaman Executions sebagai bahan diagnosis
Notifikasi hanya memberi sinyal bahwa sesuatu gagal. Diagnosis tetap membutuhkan detail eksekusi. Di n8n, halaman Executions dapat digunakan untuk melihat status workflow, node terakhir yang dijalankan, input, output, dan pesan error. Eksekusi yang gagal juga dapat dicoba ulang menggunakan workflow yang tersimpan saat ini atau versi workflow ketika kegagalan terjadi. Dokumentasi executions n8n menjelaskan kedua pilihan retry tersebut.
Ini penting ketika workflow sudah diperbaiki. Jika masalahnya ada pada konfigurasi node, retry dengan workflow terbaru mungkin tepat. Namun jika ingin mereproduksi kondisi lama, gunakan versi original agar hasil diagnosis tidak berubah karena modifikasi yang baru dilakukan.
Yang bisa dilakukan sekarang
Mulailah dari satu workflow yang paling penting bagi operasional. Tidak perlu langsung membuat sistem observability yang rumit. Lakukan langkah berikut:
- Catat tiga kegagalan yang paling mungkin terjadi.
- Tentukan mana yang layak di-retry dan mana yang harus dihentikan.
- Buat satu error workflow dengan Error Trigger.
- Kirim notifikasi ringkas ke kanal yang dipantau manusia.
- Tambahkan validasi sebelum node yang memiliki dampak besar, seperti pembayaran, pengiriman pesan, atau pengubahan data.
- Uji API timeout, input kosong, kredensial salah, dan eksekusi ulang.
- Tinjau kembali notifikasi setelah satu minggu: apakah terlalu ramai atau justru kurang informatif?
Workflow yang matang bukan workflow yang tidak pernah gagal. Workflow yang matang adalah workflow yang ketika gagal, kita segera tahu apa yang terjadi, seberapa besar dampaknya, dan tindakan berikutnya. Itulah perbedaan antara automasi yang sekadar berjalan dan automasi yang bisa dipercaya.
Sumber & bacaan lebih lanjut
- n8n Docs — Handle errors gracefully
- n8n Docs — Error Trigger node
- n8n Docs — Stop And Error node
- n8n Docs — All executions
– Rio Yotto @rioyotto